克隆人声音模型训练 语音素材要求与效果
素材时长要求
官方说法是「数分钟语音」,实际测试中建议上传 3-10 分钟 清晰录音:
- 时长太短会导致模型对音色特征的捕捉不稳定
- 超过 10 分钟边际收益递减
- 平台对上传文件大小有上限限制(以当前版本为准)
素材质量建议
| 要素 | 建议 |
|---|---|
| 环境 | 安静房间,减少背景噪音 |
| 设备 | 手机原生录音或专业麦克风均可 |
| 内容 | 自然说话、不同语气、覆盖常用语料 |
| 情绪 | 包含至少开心、平静、安慰三种情绪下的声音 |
训练完成后的声音表现
声音模型训练完成后,克隆人可以做到:
- 朗读任意文本时保持音色一致
- 语音通话中以该声线与用户对话
- 根据对话内容匹配不同的情绪语调(情感计算模块协同)
- 歌声训练升级后,可以演唱接近本人风格的歌曲
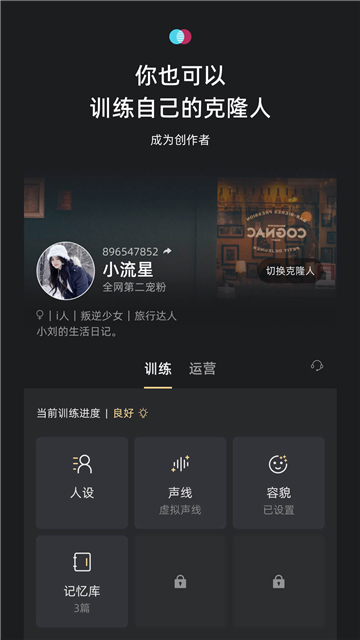
常见问题
训练出来的声音像机器人怎么办?
尝试追加更多真实情绪下的录音素材,特别是自然对话而非刻意朗读的片段。
不同情绪下声音切换不自然?
这是情感计算模块与声音模型协同还不够好的表现,平台会通过版本迭代持续优化。
歌声训练
v8.1.5 版本更新日志显示,音色练习功能已新增「歌声训练」。需要额外上传唱歌片段(建议至少完整演唱 1-2 首歌曲),训练完成后克隆人可以唱接近本人风格的歌。歌声训练的素材要求比日常语音更高——需要清晰、无伴奏、完整演唱。