X Eva 核心技术栈 XLLM 声音神经网络与视觉模型
四层技术架构
X Eva 的克隆人能力由小冰框架的四层技术协同支撑:
XLLM 语言模型
XLLM(Xiaoice Large Language Model)是小冰团队自研的大语言模型,负责:
- 克隆人对话时的自然语言理解与生成
- 根据记忆库内容保持对话上下文的一致性
- 超级模式下的逻辑推理与任务执行
- AIGC 内容生成时的文案撰写能力
XLLM 专为情感陪伴场景优化,与通用大模型相比,它在长对话记忆、角色一致性和情感反应粒度方面做了针对性调优。
声音神经网络渲染
声音模型从用户提交的数分钟真人录音中学习:
- 音色特征(共振峰、基频范围)
- 说话习惯(语速、停顿节奏)
- 情感表达(开心时语调上扬、安慰时语速放缓等模式)
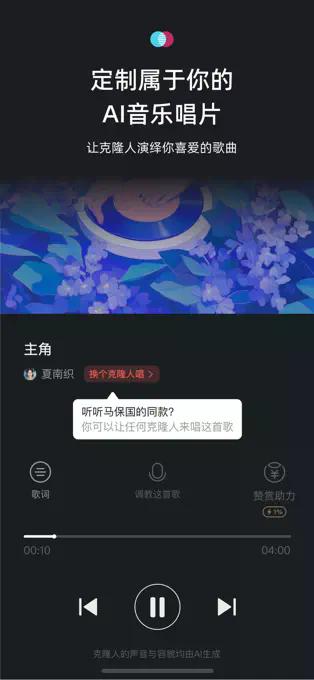
训练完成后,克隆人可以用自己的声音朗读任意文本。后续迭代中,还支持「歌声训练」——让克隆人唱出本人的唱歌风格。
视觉模型训练
视觉模型负责克隆人的外貌和视频动效:
- 从用户上传的照片/视频中提取面部特征
- 生成稳定的虚拟形象
- 支持视频通话时的面部动效(微笑、眨眼、转头等反应)
视觉模型与声音模型打通后,视频通话中的克隆人会根据对话内容实时做出表情和口型变化。
情感计算
小冰框架的传统强项,负责:
- 识别用户当前的情绪状态(从文字、语音语调中判断)
- 匹配对应的情感反应策略
- 让克隆人在对话中自然地表达共情
情感计算模块让克隆人避免变成单纯的问答机器,而是表现出「有趣的灵魂」。
双模式切换背后的技术
为什么加 V 克隆人能在「情感模式」和「超级模式」之间切换?背后是同一个 XLLM 模型加载了两种不同的系统提示和行为约束:
- 情感模式:角色人格权重优先,对话更情绪化、更具个性
- 超级模式:逻辑推理权重优先,减少人格化表达,强调任务执行的准确性和完整性
切换相当于换一套 prompt 上下文,模型本身是同一个。